Scans lesen.
Text wiederfinden.
Erstellen Sie ein neues PDF mit OCR-Textebene und prüfen Sie Inhalt, Abdeckung und Ausgabe.
Text-PDF oder Bildscan?
Ein PDF kann echten Text oder überwiegend Seitenbilder enthalten. Direkte Textextraktion und OCR sind unterschiedliche Leseverfahren. Wählen Sie eine überschaubare Quelle und prüfen Sie die gemessene Seitenabdeckung.
WhimRoom verwendet lokale Komponenten für unterstützte PDFs und Bilder. Ausrichtung, Auflösung, Sprache, Qualität und beschädigte Eingaben begrenzen das Ergebnis. Ein OCR-Wert beweist nicht, dass jede Zahl oder Formulierung korrekt erkannt wurde.
Inhalt vor dem Export prüfen.
- Öffnen Sie die Quelle im Dokumentbereich.
- Lesen Sie Seitenzahl, Methode, Text und Fehler. Nicht gelesene Seiten sind kein leerer Inhalt.
- Suchen Sie bekannte Begriffe und vergleichen Sie wichtige Stellen mit dem Originalbild.
- Prüfen Sie Namen, Beträge und Daten vor einer Weiterverwendung.
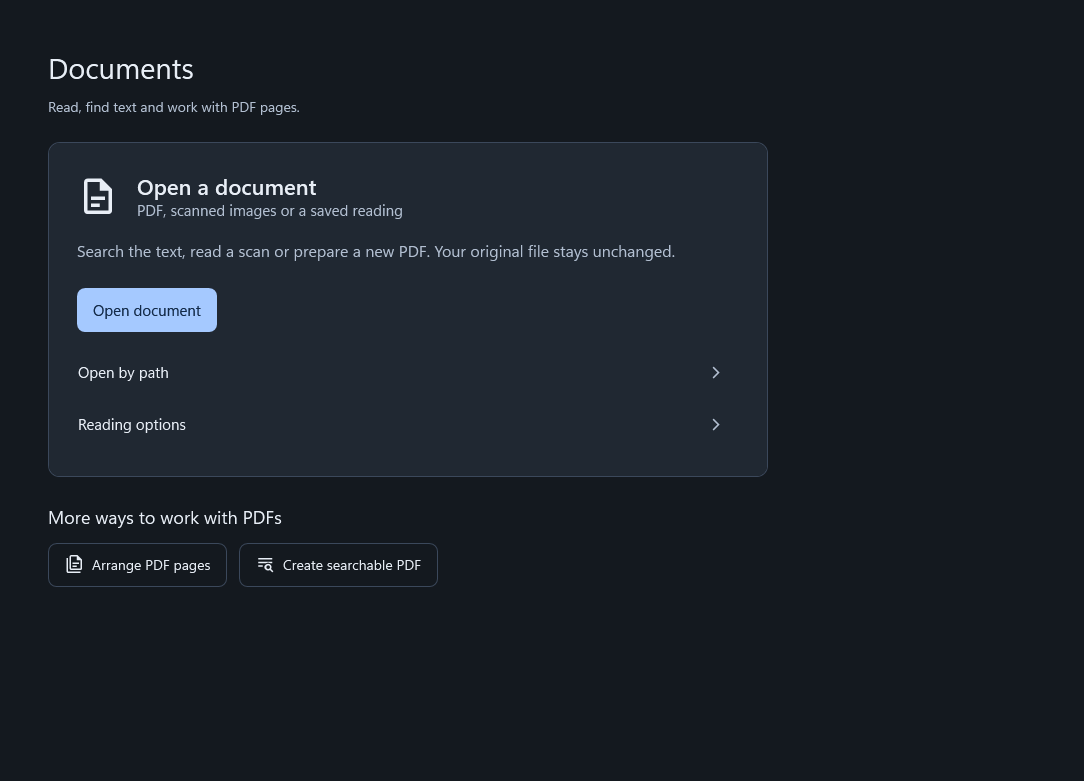
Ein neues durchsuchbares PDF.
Wählen Sie die Scan-PDF-Funktion, prüfen Sie Quellen, Ziel und Plan vor der Bestätigung. Sie erstellt ein neues Raster-PDF mit OCR-Textebene. Erhaltung von ursprünglicher PDF-Struktur, Formularen, Signaturen oder Bearbeitbarkeit wird nicht allgemein zugesagt.
Die Quelle bleibt erhalten. Wählen Sie ein neues Ziel. Kennwortschutz, beschädigte Seiten oder nicht unterstützte Eingaben können zum Fehlschlag oder unvollständiger Verarbeitung führen.
Die Ausgabe tatsächlich öffnen.
- Prüfen Sie gemeldeten Abschluss und Teilfehler.
- Öffnen Sie die neue PDF und kontrollieren Sie Folge, Ausrichtung und Lesbarkeit.
- Suchen oder markieren Sie einen bekannten Begriff. Die Textebene muss den relevanten Inhalt korrekt wiedergeben.
- Behalten Sie Original und benötigte unabhängige Sicherungen.
Datenschutz und Alternativen.
Lokale OCR übermittelt die Datei nicht allein durch das Lesen an Copperwhim. Exporte können aber private Inhalte enthalten und sind nicht automatisch verschlüsselt. Angeforderter MCP-Text gelangt zum Client und gegebenenfalls dessen Anbieter.
NAPS2 dokumentiert einen eigenen OCR-Ablauf und ist eine fokussierte Alternative. Die tatsächlichen Unterschiede prüfen, statt Ergebnisse verschiedener Engines gleichzusetzen.
Quellen und Dokumentation.
Offizielle Quellen der englischen Ausgangsfassung. Verlinkte Originaldokumente können Englisch sein; die Aussagen oben sind keine neue gemeinsame Produktmessung.